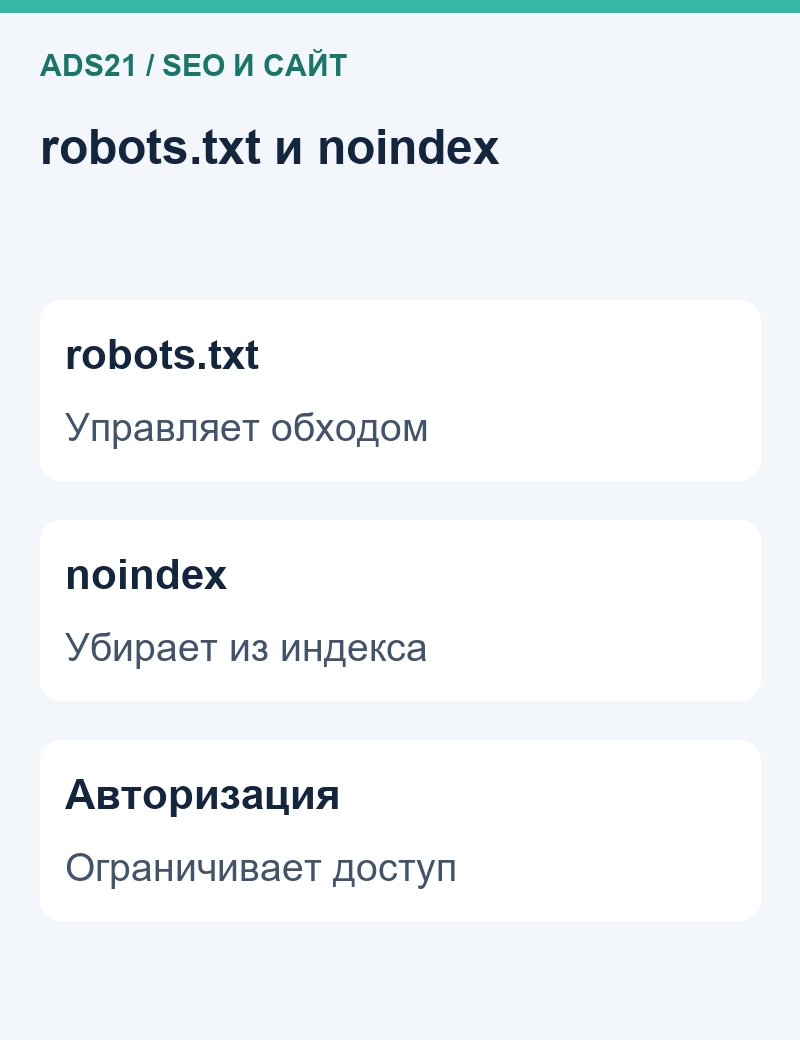
robots.txt задаёт правила обхода сайта поисковым роботом, а noindex запрещает включать страницу в поисковый индекс. Если нужно убрать доступную посетителям страницу из поиска, один запрет в robots.txt может не решить задачу. Более того, он способен помешать роботу увидеть noindex.
Начните с вопроса: вы хотите сократить обход ненужных адресов, исключить страницу из выдачи или ограничить доступ к её содержимому? От ответа зависит настройка.
- Что выбрать для своей задачи
- Что делает robots.txt
- Как работает noindex
- Почему сочетание запретов может мешать
- Как проверить результат на одном адресе
- Видео: назначение robots.txt
- Частые вопросы
- Достаточно ли Disallow, чтобы убрать страницу из поиска?
- Можно ли одновременно закрыть URL в robots.txt и добавить noindex?
- Нужно ли писать noindex в robots.txt?
- Скроет ли noindex личные документы от людей?
- Когда страница исчезнет после добавления noindex?
Что выбрать для своей задачи
Для управления обходом используют robots.txt. Для исключения конкретной открытой страницы из индекса — правило noindex в её коде или HTTP-заголовке. Если информация предназначена только для определённых людей, нужна авторизация или другое реальное ограничение доступа.
Например, у магазина есть страница для посетителей, пришедших по определённому размещению, и её не нужно показывать в поиске. Владелец может выбрать noindex, сохранив возможность открыть страницу по ссылке. Это отдельная задача от ограничения обхода большого числа технических URL.
Не используйте поисковые настройки вместо защиты данных. Даже исключённая из выдачи страница может оставаться доступной человеку, который знает её адрес. Список правил robots.txt тоже обычно открыт для просмотра.
Что делает robots.txt
Файл находится в корне сайта. Правила задают для определённого робота или группы роботов. Например, Disallow запрещает обход указанного пути. Такие ограничения помогают управлять посещениями робота, но не являются универсальным способом удалить URL из поиска.
Робот может узнать о закрытом адресе по ссылкам с других страниц. В результате адрес может появиться в выдаче, даже если робот не прочитал содержимое страницы. Поэтому проверка «я добавил Disallow, значит, страница точно исчезнет» недостаточна.
Не переносите чужой robots.txt целиком. Путь, который у одного сайта ведёт на технический раздел, у другого может содержать полезные материалы. Перед изменением запишите конкретные URL, которых оно должно коснуться, и проверьте правила для нужного поискового робота.
Как работает noindex
Для HTML-страницы правило можно разместить в метатеге robots внутри head:
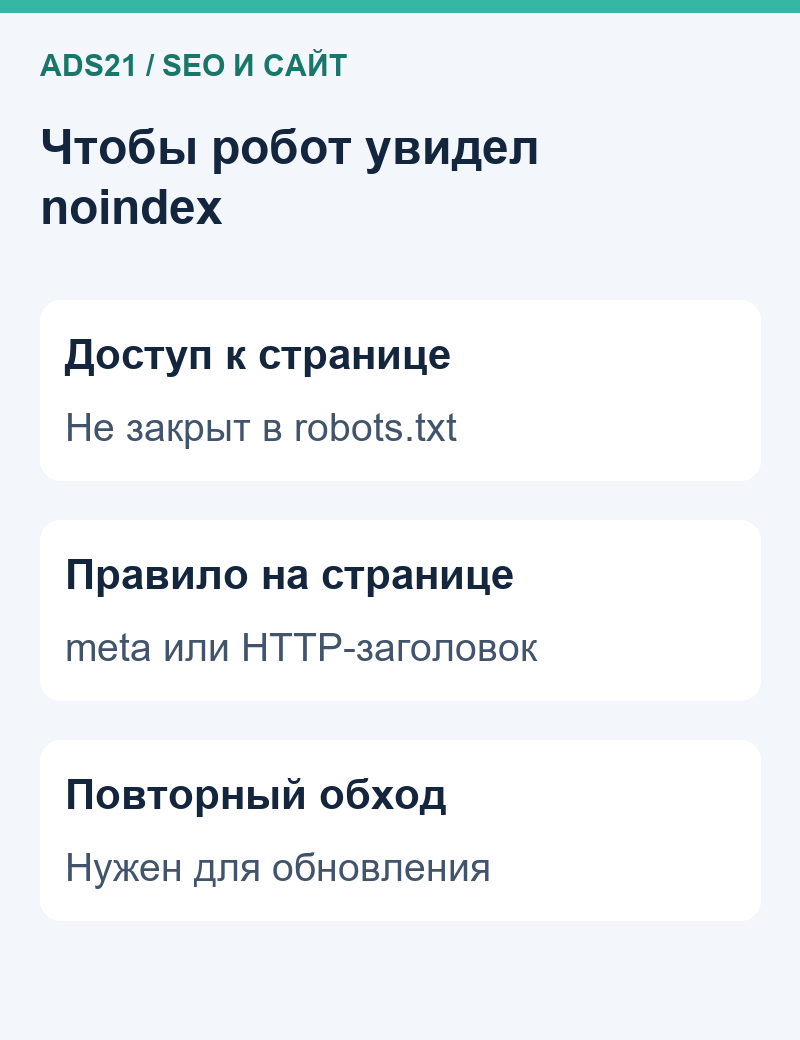
<meta name="robots" content="noindex">Другой способ — HTTP-заголовок ответа X-Robots-Tag: noindex. Его настраивают на стороне сервера или приложения. Проверять нужно фактически полученный ответ, а не только галочку в панели управления сайтом.
Робот должен загрузить страницу, чтобы прочитать правило. Если тот же URL закрыт для него в robots.txt, noindex может остаться незамеченным. Google не поддерживает запись правила noindex в самом файле robots.txt: это не замена метатегу или заголовку.
Добавление запрета не означает мгновенное изменение выдачи. Сначала поисковой системе нужно обнаружить обновление. Не обещайте точный срок исчезновения страницы только по факту сохранения настройки.
Почему сочетание запретов может мешать
Представим страницу, которая уже участвует в поиске. На ней добавили noindex и одновременно запретили её обход. Владелец видит два ограничения и ожидает быстрого результата, но робот может не попасть на страницу и не прочитать новое правило.
Если цель — убрать открытую страницу из поиска с помощью noindex, проверьте, что нужному роботу разрешён доступ к этому URL. Не снимайте ограничения со всего сайта: достаточно проверить правила, относящиеся к выбранному адресу. Изменение общего шаблона или правила для каталога затронет больше страниц, чем правка одной записи.
У страницы, которая должна участвовать в поиске, возможна другая проблема: noindex может остаться после переноса из тестовой среды. Проверьте настройки перед запуском рекламы и поискового продвижения. Сам по себе запрет индексации не мешает человеку открыть страницу по рекламной ссылке, но ограничивает её участие в органическом поиске.
Как проверить результат на одном адресе
- Запишите точный URL. Учтите протокол, домен, путь и параметры, если они есть.
- Откройте страницу и проверьте ответ сервера. Если есть перенаправление, запишите конечный URL и проверьте уже его.
- Проверьте относящиеся к URL правила robots.txt для нужного робота.
- Посмотрите метатег robots в HTML и HTTP-заголовок X-Robots-Tag. Сравните их с тем, что вы хотели настроить.
- Проверьте адрес в инструментах поисковой системы. Различайте текущую доступность для обхода и сведения о последнем известном состоянии в поиске.
Сохраните время изменения и результат проверки. Если настройка ещё не отразилась в выдаче, сначала убедитесь, что робот может её обнаружить. Несколько быстрых переключений между Disallow и noindex затруднят диагностику: будет непонятно, какое состояние успела получить поисковая система.
Для общей проверки сайта используйте руководство по SEO-оптимизации. А у рекламных посадочных страниц отдельно проверьте ссылки с UTM-метками: доступность по ссылке и участие в поиске — разные результаты проверки.
Видео: назначение robots.txt
Короткий разбор показывает роль файла и основные обозначения. При выборе способа исключения страницы учитывайте различие между правилами обхода и noindex, разобранное выше.
Частые вопросы
Достаточно ли Disallow, чтобы убрать страницу из поиска?
Нет. Закрытый для обхода URL может оставаться в результатах поиска. Для исключения открытой страницы используют noindex, который робот должен суметь прочитать.
Можно ли одновременно закрыть URL в robots.txt и добавить noindex?
Такая комбинация может помешать роботу обнаружить noindex. Если рассчитываете на это правило, проверьте доступ к странице для нужного робота.
Нужно ли писать noindex в robots.txt?
Для Google это неподдерживаемый способ. Используйте метатег в HTML или HTTP-заголовок ответа.
Скроет ли noindex личные документы от людей?
Нет. Правило относится к поисковой индексации и не заменяет авторизацию. Доступ к закрытой информации нужно ограничивать отдельно.
Когда страница исчезнет после добавления noindex?
После того как поисковая система обнаружит правило и обработает изменение. Не считайте само сохранение настройки подтверждением обновлённой выдачи.